 Oliver Gundlach
Was an KI günstiger geworden ist, warum neue Spitzenmodelle mehr kosten können und wann eigene Hardware als Alternative infrage kommt.
KI-Tokenpreise entwickeln sich nicht einheitlich. OpenAI senkte 2025 den Preis des unveränderten Modells o3 um 80 Prozent; auch ein festes Testniveau wurde deutlich günstiger erreichbar. Neue Spitzenmodelle können zugleich mehr pro Token kosten. Für Unternehmen zählt die Rechnung pro erledigter Aufgabe: Verbrauch, Ergebnisqualität und menschliche Nacharbeit zusammen.
Wer KI auf eigener Hardware betreibt, zahlt für diese Modellnutzung keine laufenden Tokengebühren an einen Cloudanbieter. Bei ausreichender Nutzung kann das eine günstigere Alternative sein. Allerdings müssen dafür ein geeignetes Modell, die Hardware und ihr Betrieb zusammenpassen.
Ein häufiges Argument für den eigenen Server geht weiter: Die großen KI-Anbieter würden uns zunächst mit niedrigen Preisen abhängig machen und später kräftig erhöhen. Wer deshalb Hardware kauft, trifft eine Investitionsentscheidung aufgrund einer Erwartung über künftige Preise. Wie gut trägt diese Erwartung?
Die bisherige Entwicklung ergibt ein differenzierteres Bild: Bestimmte Leistungsniveaus sind erheblich günstiger verfügbar geworden. Neue Spitzenmodelle können zugleich höhere Tokenpreise haben und anspruchsvollere Aufgaben bewältigen. Für die eigene Kostenplanung muss man diese Entwicklungen auseinanderhalten.
Welche Preise vergleichen wir?
Hier geht es um API-Preise. Über diese Schnittstelle nutzen Programme und automatisierte Workflows ein Sprachmodell direkt und bezahlen nach Verbrauch. Abgerechnet werden Token, also kleine Textbausteine: die Eingabe an das Modell und die erzeugte Ausgabe. Für beide gelten meist unterschiedliche Preise je Million Token.
Chat-Abonnements haben eine andere Tariflogik: einen Monatsbetrag je Nutzer mit Nutzungsgrenzen. Aus diesem Betrag lässt sich kein allgemeiner Tokenpreis ableiten. Der Vergleich in diesem Artikel betrifft deshalb die Modellnutzung über APIs.
Was ist tatsächlich günstiger geworden?
Der eindeutigste Fall ist eine Preissenkung beim unveränderten Modell. OpenAI senkte die Tokenpreise von o3 im Juni 2025 um 80 Prozent auf 2 US-Dollar je Million Eingabe-Token und 8 Dollar je Million Ausgabe-Token. Laut Anbieter blieb das Modell exakt dasselbe; effizientere technische Abläufe machten den Betrieb günstiger.[1] Wer es mit demselben Verbrauch nutzte, zahlte anschließend ein Fünftel.
Eine andere Frage ist, wie günstig ein bestimmtes Leistungsniveau im Lauf der Zeit erreichbar wird. Epoch AI untersuchte dafür mehrere Tests und feste Leistungsschwellen. Ein Beispiel: Mindestens das Niveau des ursprünglichen GPT-4 im Wissenstest MMLU kostete im März 2023 noch 37,50 Dollar je Million Token. Mit Gemini 2.0 Flash waren es im Februar 2025 rund 0,18 Dollar, also ungefähr ein Zweihundertstel. Die Auswertung gewichtet Eingabe-Token mit 75 Prozent und Ausgabe-Token mit 25 Prozent.[2]
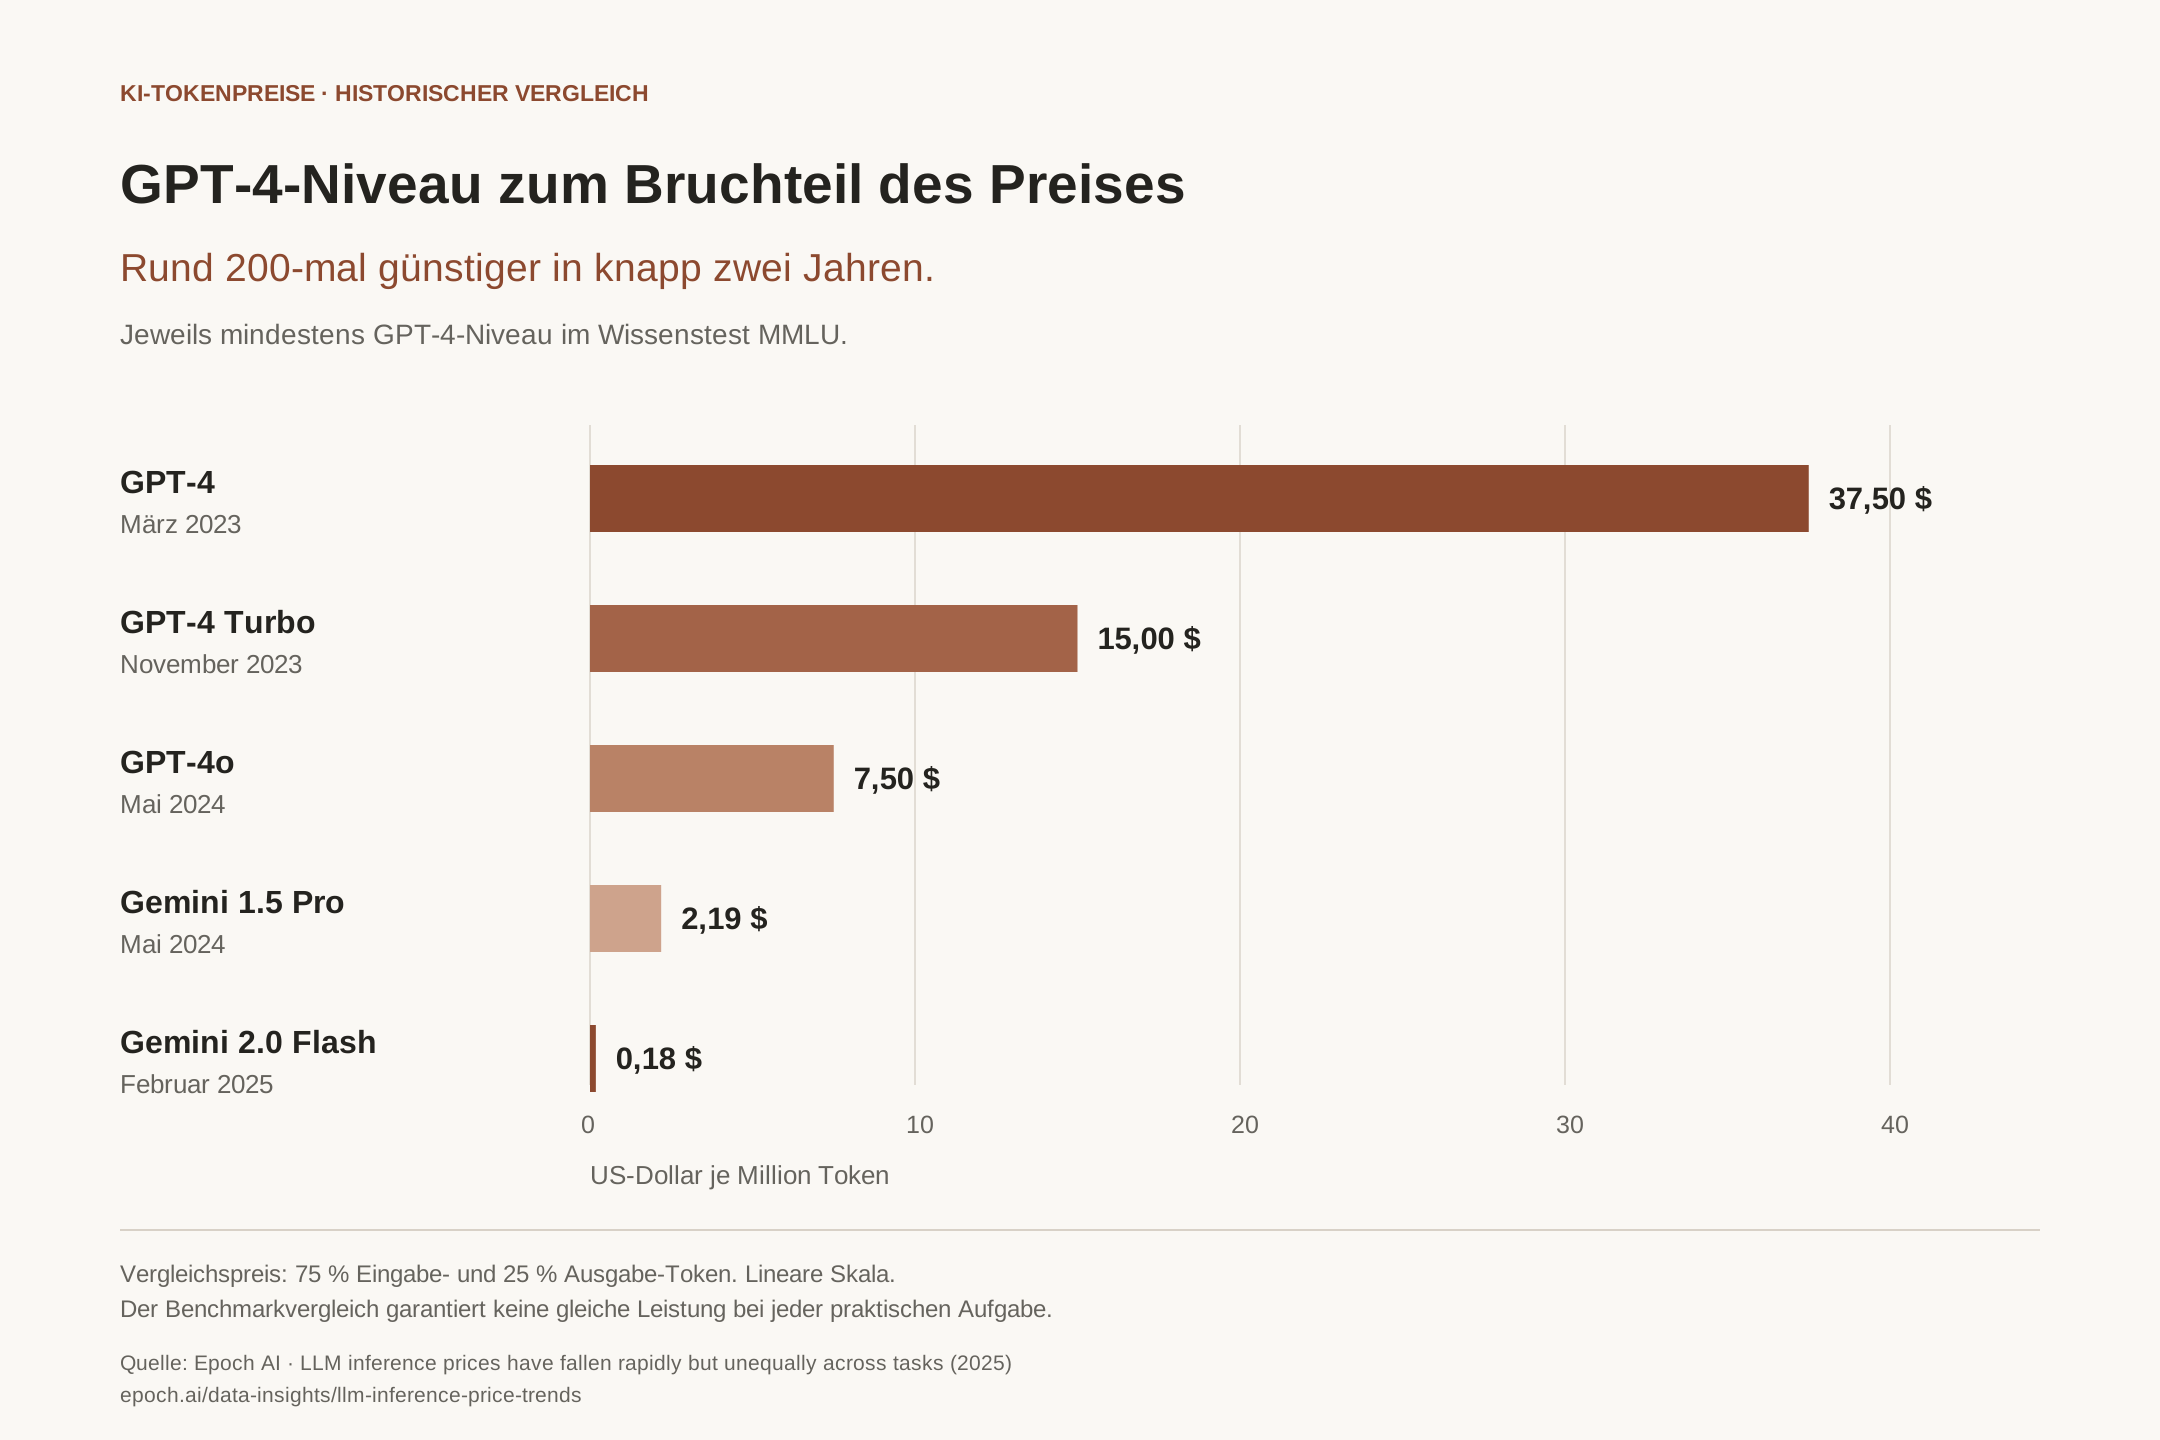
Das ist ein deutlicher Preisverfall bei einer festgelegten Testleistung. Die Aussage „Vergleichbare Intelligenz wird immer billiger“ geht aber weiter, als diese Daten tragen. Ein Wissenstest bildet weder die Verlässlichkeit bei langen Dokumenten noch sämtliche Anforderungen eines Geschäftsprozesses ab. Epoch schloss zudem Modelle mit zusätzlichem internem Rechnen aus diesem Tokenpreisvergleich aus, weil deren höherer Verbrauch den Vergleich verzerren kann.[2]
Belegt ist, dass bestimmte messbare Leistungsniveaus erheblich günstiger erreichbar wurden. Ob ein günstigeres Modell die eigene Aufgabe ebenso gut erledigt, muss sich an dieser Aufgabe zeigen. Eine Garantie für die Preisentwicklung heutiger Spitzenleistung lässt sich daraus nicht ableiten.
Werden die Spitzenmodelle teurer und leistungsfähiger?
Bei einzelnen Generationswechseln steigen die Tokenpreise tatsächlich deutlich. Ein Beispiel ist der Wechsel von GPT-5.4 zu GPT-5.5:
| Modell | Eine Million Eingabe-Token | Eine Million Ausgabe-Token |
|---|---|---|
| GPT-5.4[3] | 2,50 US-Dollar | 15 US-Dollar |
| GPT-5.5[4] | 5 US-Dollar | 30 US-Dollar |
Standardpreise laut Modelldokumentation, geprüft am 10. September 2026; ohne Rabatte und Zuschläge, für Anfragen bis 272.000 Eingabe-Token.
Damit verdoppelt sich der Tokenpreis beim Wechsel. Zugleich beschreibt OpenAI für GPT-5.5 Fortschritte bei komplexen Arbeitsabläufen, beim Befolgen von Anweisungen und beim Einsatz von Werkzeugen. Laut Anbieter benötigt das Modell für starke Ergebnisse außerdem weniger interne Denk-Token als frühere Modelle.[5] Höhere Tokenpreise können also mit besseren Ergebnissen und geringerem Verbrauch je Aufgabe zusammenkommen. Wie viel davon in einer konkreten Anwendung ankommt, lässt sich aus der Preisliste allein nicht ablesen.
Eine durchgehend steigende Preisreihe gibt es aber auch bei Spitzenmodellen nicht. Anthropic senkte die Preise innerhalb seiner Opus-Reihe von 15 auf 5 Dollar je Million Eingabe-Token und von 75 auf 25 Dollar je Million Ausgabe-Token beim Übergang von Opus 4.1 zu 4.5.[6] Gleichzeitig stellte der Anbieter Opus 4.5 als leistungsfähigeres Modell vor.[7]
Wer immer die leistungsfähigste verfügbare Lösung für seine Aufgaben nutzen möchte, kann somit auch einen höheren Preis bezahlen müssen. Das widerspricht nicht der Beobachtung, dass ein früheres Leistungsniveau inzwischen günstiger erhältlich ist. Es beantwortet eine andere Frage.
Warum der Tokenpreis noch keine Rechnung ist
Eine API-Rechnung hängt vom gewählten Modell, seinen Preisen und dem tatsächlichen Verbrauch ab. Sinkt der Preis bei gleicher Mischung aus Eingabe und Ausgabe auf ein Zehntel und steigt der Verbrauch auf das Hundertfache, wird die Rechnung zehnmal so hoch. Dieses Rechenbeispiel zeigt den Mengeneffekt: Wer mehr Aufgaben automatisiert oder längere Dokumente verarbeitet, kann trotz günstigerer Token mehr bezahlen.
Auch dieselbe Aufgabe kann je nach Modell und Einstellung unterschiedlich viele Token benötigen. Bei Modellen mit internem Rechnen zählen die Denk-Token mit zur Abrechnung, obwohl sie nicht als Teil der sichtbaren Antwort erscheinen.[8] Ein Modell kann mehr Rechenaufwand für eine bessere Lösung einsetzen. Ein anderes kann das gewünschte Ergebnis mit weniger Schritten erreichen.
Für Unternehmen zählt deshalb, was ein ausreichend gutes Ergebnis insgesamt kostet. Ein teureres Modell kann die wirtschaftlichere Wahl sein, wenn seine besseren Ergebnisse mehr Nacharbeit einsparen, als die zusätzliche Modellnutzung kostet.
Ein illustratives Beispiel: Eine Aufgabe kostet beim günstigeren Modell 10 Cent, beim leistungsfähigeren 50 Cent. Der Mehrpreis beträgt 40 Cent je Vorgang. Bei angenommenen Arbeitskosten von 60 Euro pro Stunde kostet eine Minute Nacharbeit einen Euro. Spart das leistungsfähigere Modell im Durchschnitt eine solche Minute je Vorgang, sinken die Gesamtkosten um 60 Cent. Trotz des höheren Modellpreises.
Ob diese Ersparnis entsteht, muss sich an den tatsächlichen Ergebnissen und der benötigten Nacharbeit zeigen. Entscheidend sind dabei sowohl die Häufigkeit der Fehler als auch der Aufwand, sie zu erkennen und zu korrigieren. Für eine einfache Aufgabe kann das günstigere Modell bereits ausreichen. Die geforderte Qualität legt ein Mensch fest; bei entscheidungsrelevanten Ergebnissen bleiben fachliche Prüfung und Entscheidung bei den zuständigen Mitarbeitern.
Was bedeutet das für eigene Hardware?
Die Aussicht auf niedrige Kosten je verarbeiteter Aufgabe macht eigene Hardware als Alternative interessant. Dafür muss das selbst betriebene Modell die benötigte Qualität und Geschwindigkeit erreichen. Der Kauf eines Servers verschafft keinen automatischen Zugang zu den Modellen, die ein Anbieter ausschließlich als Cloud-Dienst bereitstellt.
In der Kostenrechnung treten an die Stelle der API-Gebühren Anschaffung, Strom und Betreuung der eigenen Modellinfrastruktur. Bei geringer Nutzung verteilen sich diese Kosten auf wenige Aufgaben. Bei hoher Auslastung kann der lokale Betrieb günstiger werden. Umgekehrt machen niedrige Cloud-Tokenpreise es schwieriger, eine Neuanschaffung allein durch eingesparte API-Gebühren zu rechtfertigen.
Künftige Preiserhöhungen gehören als Szenario in diese Rechnung. Wettbewerb und selbst betreibbare Modelle können den Preisspielraum der Anbieter begrenzen. Eine feste Preisobergrenze entsteht daraus jedoch nicht: Alternativen müssen die Aufgabe ausreichend gut erfüllen, und ein Wechsel kann Anpassungen und neue Prüfungen erfordern. Ob die heutigen Preise sämtliche Kosten der Anbieter decken, können wir von außen ebenfalls nicht verlässlich beurteilen.
Wir nutzen bewusst Cloudmodelle von OpenAI und Anthropic, weil sie die Leistung für unsere Aufgaben liefern. Dabei messen wir den Verbrauch und prüfen, welche Modelle brauchbare Ergebnisse zu vertretbaren Kosten liefern. Allein aus der Erwartung stark steigender API-Preise ergibt sich für uns noch kein wirtschaftlicher Grund, einen eigenen Server anzuschaffen.
Vergleichen Sie die Kosten derselben Aufgabe bei der benötigten Ergebnisqualität, einschließlich Verbrauch und menschlicher Nacharbeit.
Eigene Hardware kann aus wirtschaftlichen oder betrieblichen Gründen sinnvoll sein, etwa bei hoher Auslastung oder wenn die Anwendung ohne Internet funktionieren muss. Welcher Aufwand und welche Kosten damit verbunden sind und wie Datenschutz und Verantwortung in die Entscheidung eingehen, betrachten wir im nächsten Artikel zu lokaler KI und Cloud.
In der KI-Standortbestimmung bewerten wir Nutzen, Aufwand und Risiko eines konkreten KI-Einsatzes.
Weiterlesen im Maschinenraum
- Lokale KI oder Cloud: Wann lohnt sich welcher Betrieb?
- Wie zuverlässig prüft KI Lohnabrechnungen? Vier Modelle im Test
- Workflow-Automatisierung: Fünf Fragen vor dem Betrieb
Quellen
- OpenAI: „O3 is 80% cheaper and introducing o3-pro“ (10. Juni 2025)community.openai.com ↗↩
- Epoch AI: „LLM inference prices have fallen rapidly but unequally across tasks“ (12. März 2025)epoch.ai ↗↩
- OpenAI: „GPT-5.4 Model“ (abgerufen am 10. September 2026)developers.openai.com ↗↩
- OpenAI: „GPT-5.5 Model“ (abgerufen am 10. September 2026)developers.openai.com ↗↩
- OpenAI: „Model guidance: Using GPT-5.5“ (abgerufen am 10. September 2026)developers.openai.com ↗↩
- Anthropic: „Pricing“ (abgerufen am 10. September 2026)platform.claude.com ↗↩
- Anthropic: „Introducing Claude Opus 4.5“ (24. November 2025)anthropic.com ↗↩
- OpenAI: „Reasoning models“ (abgerufen am 10. September 2026)developers.openai.com ↗↩