 Oliver Gundlach
Was ein Entscheidungsmodell in einem Ablauf leistet, wo es danebenliegt und was ein Urteil kostet - geprüft an Einzelfällen und 1.000 synthetischen Supportanfragen.
Jev ist TypeSafes erstes „System One Model“: ein KI-Modell für Entscheidungen innerhalb von Software. Es schreibt keine Antworten, Zusammenfassungen oder Programme. Es erhält Daten und klar definierte Fragen. Die Ausgabe besteht aus vorher festgelegten Werten und Wahrscheinlichkeiten, die ein Programm direkt weiterverarbeiten kann.
Auch ein Sprachmodell kann Nachrichten klassifizieren und seine Antwort als JSON ausgeben. Ein einzelnes richtiges Ergebnis zeigt deshalb noch keinen praktischen Unterschied. Entscheidend ist der Einsatz in einem Workflow: Welche Urteile liefert das Modell? Wie verlässlich zeigt es Unsicherheit an? Wie viel Zeit und Geld kostet jeder Aufruf? Welche Aufgaben eignen sich für Code oder ein Sprachmodell, und welche sollte ein Mensch übernehmen?
Wir haben Jev an deutschen Einzelfällen und an 1.000 synthetischen Supportanfragen untersucht. Die Ergebnisse zeigen eine Modellklasse mit einem klaren Einsatzgebiet. Sie zeigen auch, wie schnell ein falscher Aufgabenzuschnitt zu überzeugend wirkenden, aber unbrauchbaren Antworten führt.
Ein Modell für typisierte Entscheidungen
Der Name „System One“ greift Daniel Kahnemans Unterscheidung zwischen schnellem, intuitivem Denken und langsamem, überlegtem Denken auf.[1] Jev ist für eng begrenzte Urteile gebaut, die eine fachkundige Person mit dem nötigen Kontext in wenigen Sekunden treffen könnte.[2]
Ein Aufruf besteht aus einem state und einer oder mehreren Fragen. Der State enthält das Material, über das entschieden werden soll: eine Nachricht, strukturierte Daten, eine Richtlinie oder eine Kombination daraus. Für die Fragen gibt es drei Typen:
- Choice wählt eine Option aus einer vorgegebenen Liste.
- Score ordnet den Fall auf einer beschriebenen Skala ein.
- Noul gibt die Wahrscheinlichkeit aus, dass eine Aussage zutrifft.
Choice und Score liefern zusätzlich eine Verteilung über die möglichen Antworten und einen Konfidenzwert. Bei Noul ist die Wahrscheinlichkeit selbst das Ergebnis. Ein Wert von 0,5 bedeutet, dass das Modell Ja und Nein für gleich wahrscheinlich hält. Er bezeichnet keine mittlere Ausprägung.
Alle Fragen eines Aufrufs sehen denselben State und werden unabhängig voneinander ausgewertet. Jev erzeugt keine freie Antwort, die anschließend geparst werden muss. Die Ausgabe hält sich an das vorgegebene Schema. Diese formale Sicherheit sagt allerdings noch nichts über die sachliche Richtigkeit aus. Das Modell kann einen gültigen Wert liefern und inhaltlich falsch liegen.
Eine Mail, sechs Entscheidungen
Unser erstes Beispiel war eine fiktive Nachricht an ein Lohnbüro. Die Absenderin meldet eine Differenz bei den ausgezahlten Überstunden und benötigt bis Freitag eine Verdienstbescheinigung. Außerdem erwähnt sie eine Krankmeldung, die bereits über eine App eingereicht wurde.
Wir stellten sechs Fragen: Was ist das Hauptanliegen? Wird eine Korrektur verlangt? Wird eine Bescheinigung benötigt? Meldet die Nachricht eine neue Krankheit? Wie dringend ist sie? Sind alle Angaben zur Prüfung der Überstunden vollständig?
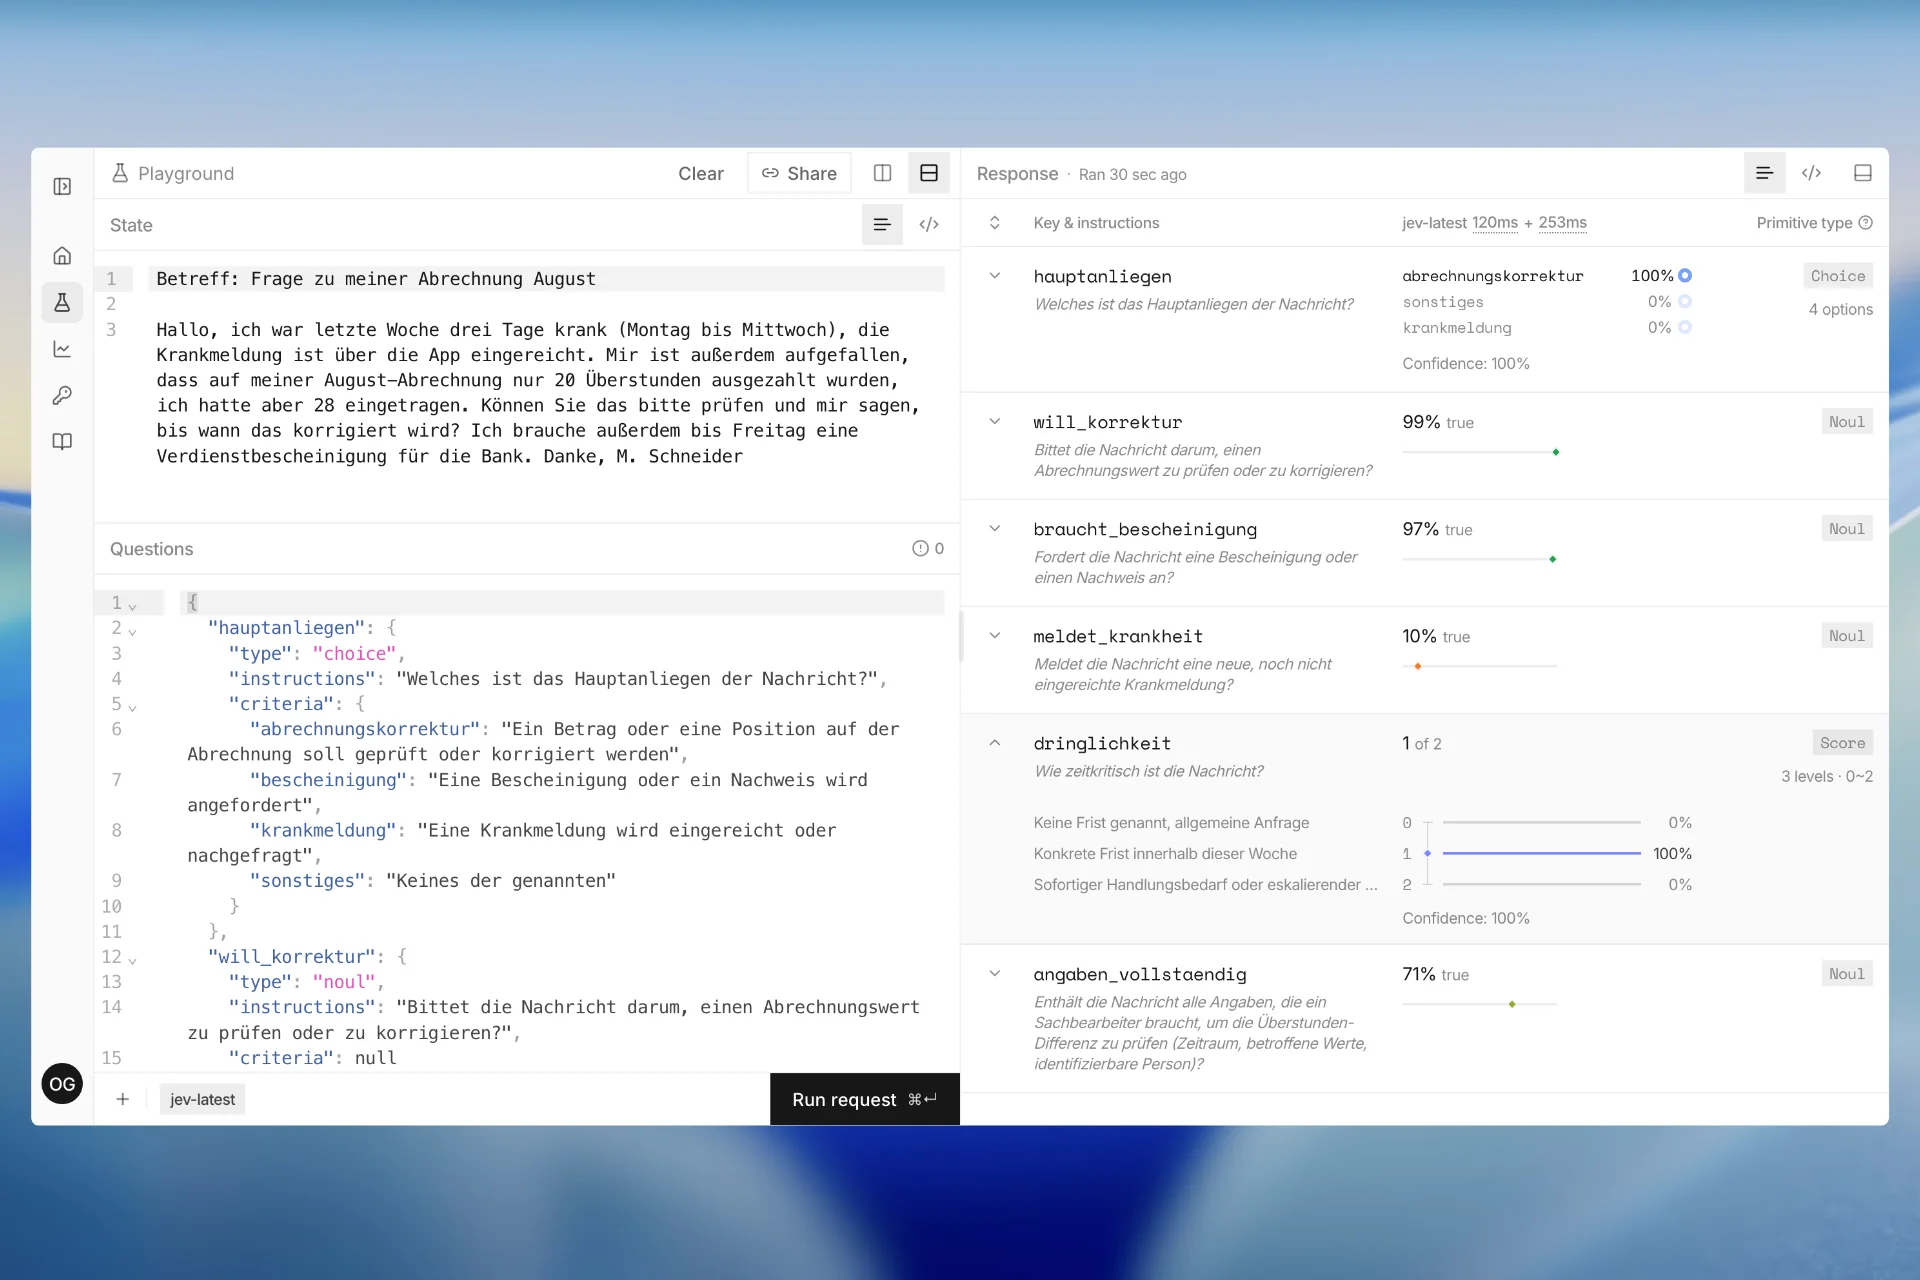
Jev wählte die Abrechnungskorrektur als Hauptanliegen. Die einzelnen Ja-Nein-Fragen erkannte es ebenfalls: Korrektur 99 Prozent, Bescheinigung 97 Prozent, neue Krankmeldung 10 Prozent. Die konkrete Frist landete auf der mittleren Dringlichkeitsstufe. Bei der Vollständigkeit blieb das Ergebnis mit 71 Prozent sichtbar weniger eindeutig.
Die Krankmeldung war die interessanteste Zeile. Das Wort steht ausdrücklich in der Mail. Gefragt war jedoch, ob hier eine neue Krankmeldung eingereicht wird. Der niedrige Wert zeigt, dass Jev in diesem Fall die Aussage bewertet und keine einfache Wortsuche ausführt.
Für eine Gegenprobe änderten wir genau einen Halbsatz. Aus „die Krankmeldung ist über die App eingereicht“ wurde „die Krankmeldung reiche ich hiermit ein“. Alle Fragen blieben gleich. Die Wahrscheinlichkeit für eine neue Krankmeldung stieg von 10 auf 91 Prozent. Die übrigen Werte bewegten sich kaum.
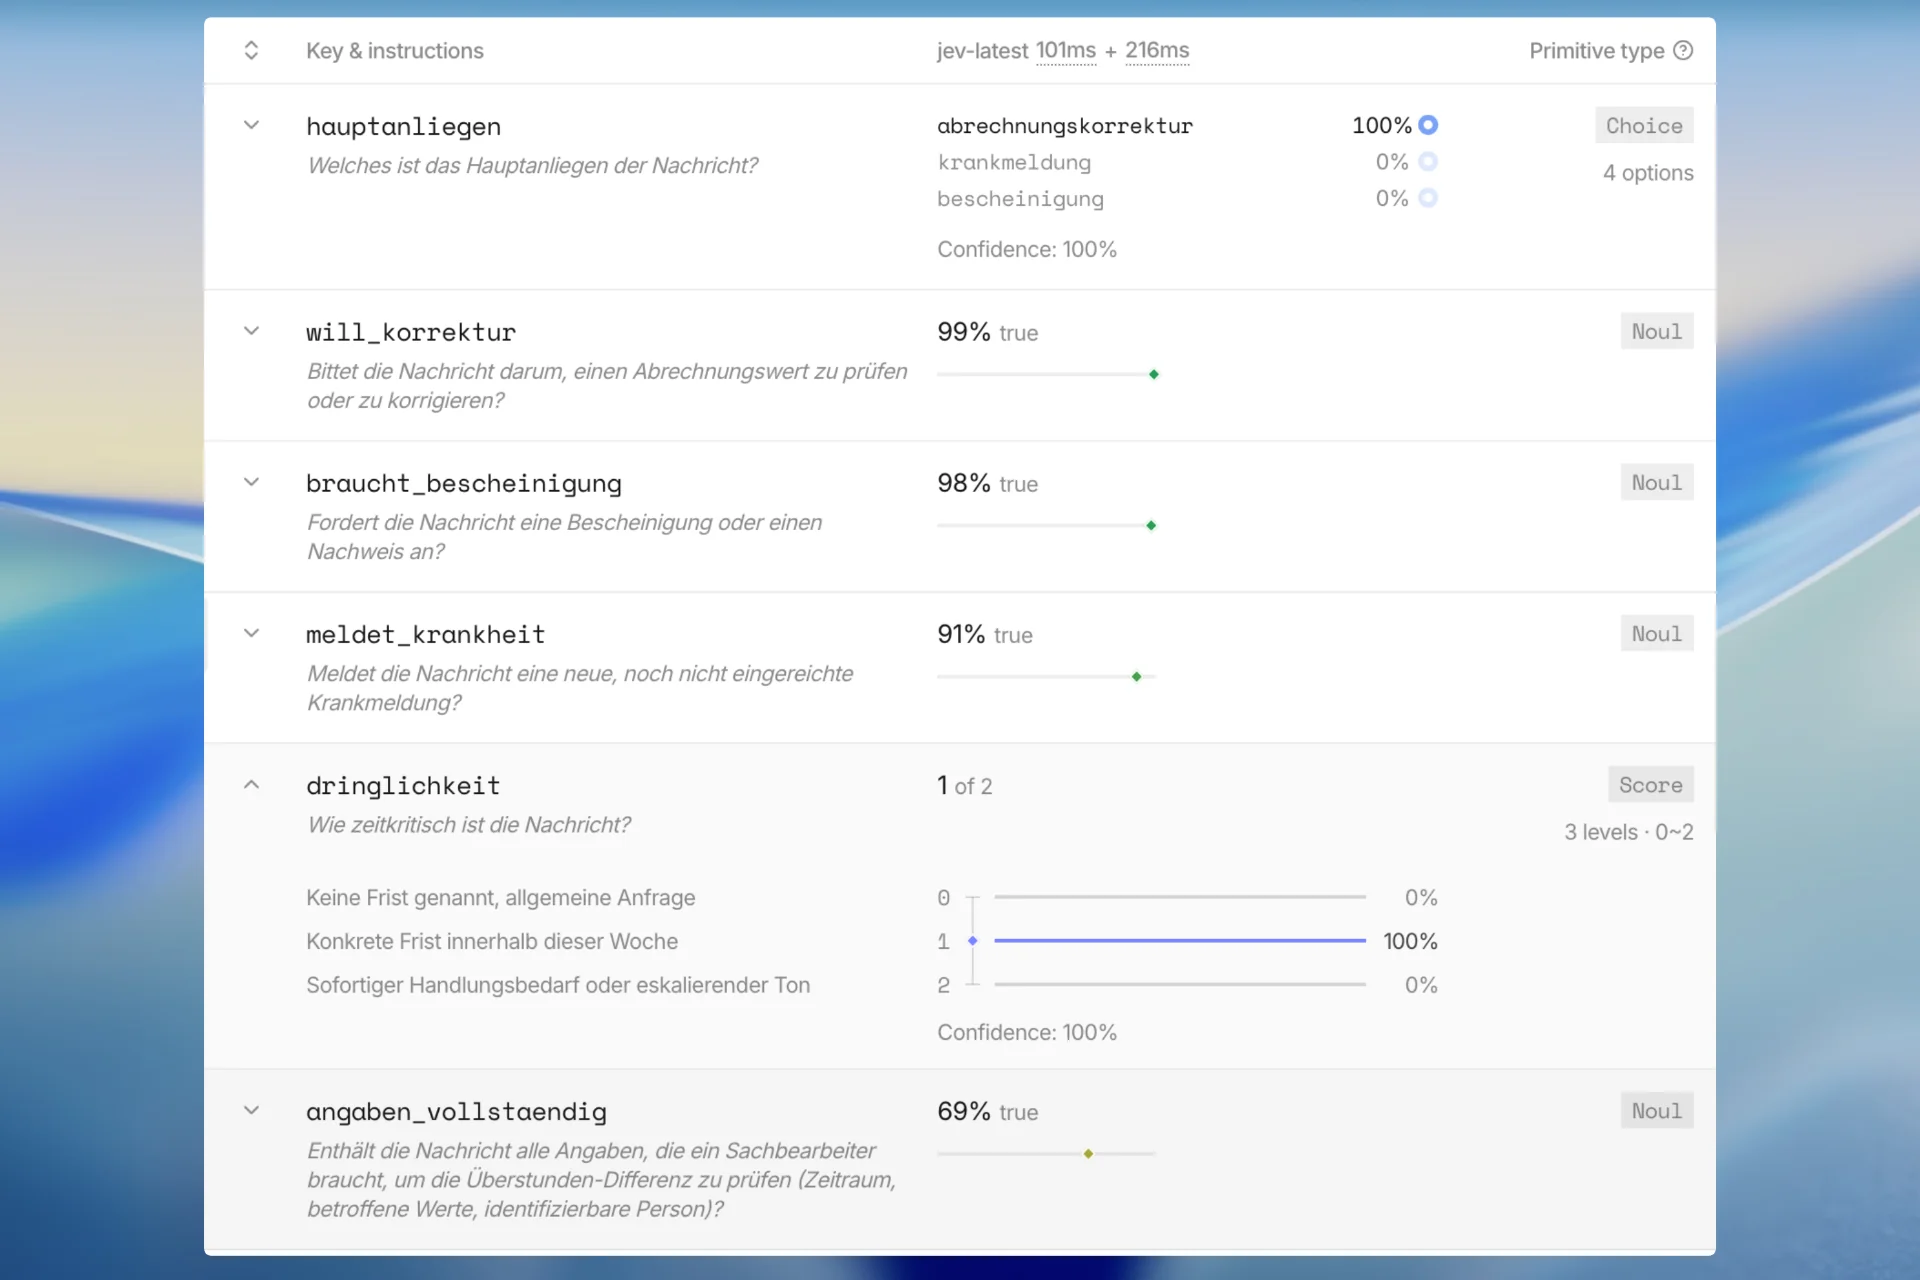
Die Gegenprobe erklärt den Mechanismus besser als eine allgemeine Definition: Eine sprachliche Änderung führt zu einem anderen typisierten Urteil. Ein Programm kann diesen Wert prüfen und den Fall anschließend weiterleiten, zurückstellen oder einem Menschen vorlegen.
Die Frage bestimmt den Nutzen der Antwort
Im selben Versuch blieb die Choice-Frage nach dem Hauptanliegen bei der Abrechnungskorrektur - selbst in der geänderten Mail, in der wörtlich eine Krankmeldung eingereicht wurde: Die passende Option erhielt 0 Prozent, während die Ja-Nein-Frage zur selben Sache bei 91 Prozent stand. Das ist kein Widerspruch, sondern die Konstruktion einer Choice. Sie wählt genau eine Option, und ihre Verteilung beschreibt, welche davon am ehesten das Hauptanliegen ist. Welche weiteren Anliegen ebenfalls vorkommen, beantwortet sie nicht - auch dann nicht, wenn eines wörtlich zutrifft.
Ein Workflow, der alle Aufträge einer Nachricht erkennen soll, braucht deshalb einzelne Fragen: Wird eine Korrektur verlangt? Wird eine Bescheinigung benötigt? Wird eine Krankmeldung eingereicht? Mehrere Antworten können gleichzeitig positiv sein. Der anschließende Code legt fest, welche Kombination welche Bearbeitung auslöst.
Diese Zerlegung ist ein zentraler Teil der Arbeit mit Jev. Breite Fragen bündeln mehrere Bewertungen in einem Ergebnis. Fehler lassen sich dann schwer zuordnen und Schwellenwerte kaum sinnvoll setzen. Atomare Fragen machen sichtbar, welcher Teil eines Falls sicher erkannt wurde und wo Informationen oder Eindeutigkeit fehlen. TypeSafe empfiehlt diesen Aufbau auch in der technischen Dokumentation.[3]
Die Wahrscheinlichkeiten benötigen ebenfalls einen festgelegten Umgang. Kalibrierung gilt über Gruppen von Antworten. Eine einzelne Antwort mit 90 Prozent kann falsch sein. In einer ausreichend großen Gruppe ähnlich sicherer Antworten sollten ungefähr 90 Prozent richtig sein. Der Ablauf muss deshalb vorab bestimmen, ab welchem Wert er automatisch handelt, wann er zusätzliche Informationen anfordert und wann ein Mensch übernimmt.
Rechnen und Regeln sind verschiedene Aufgaben
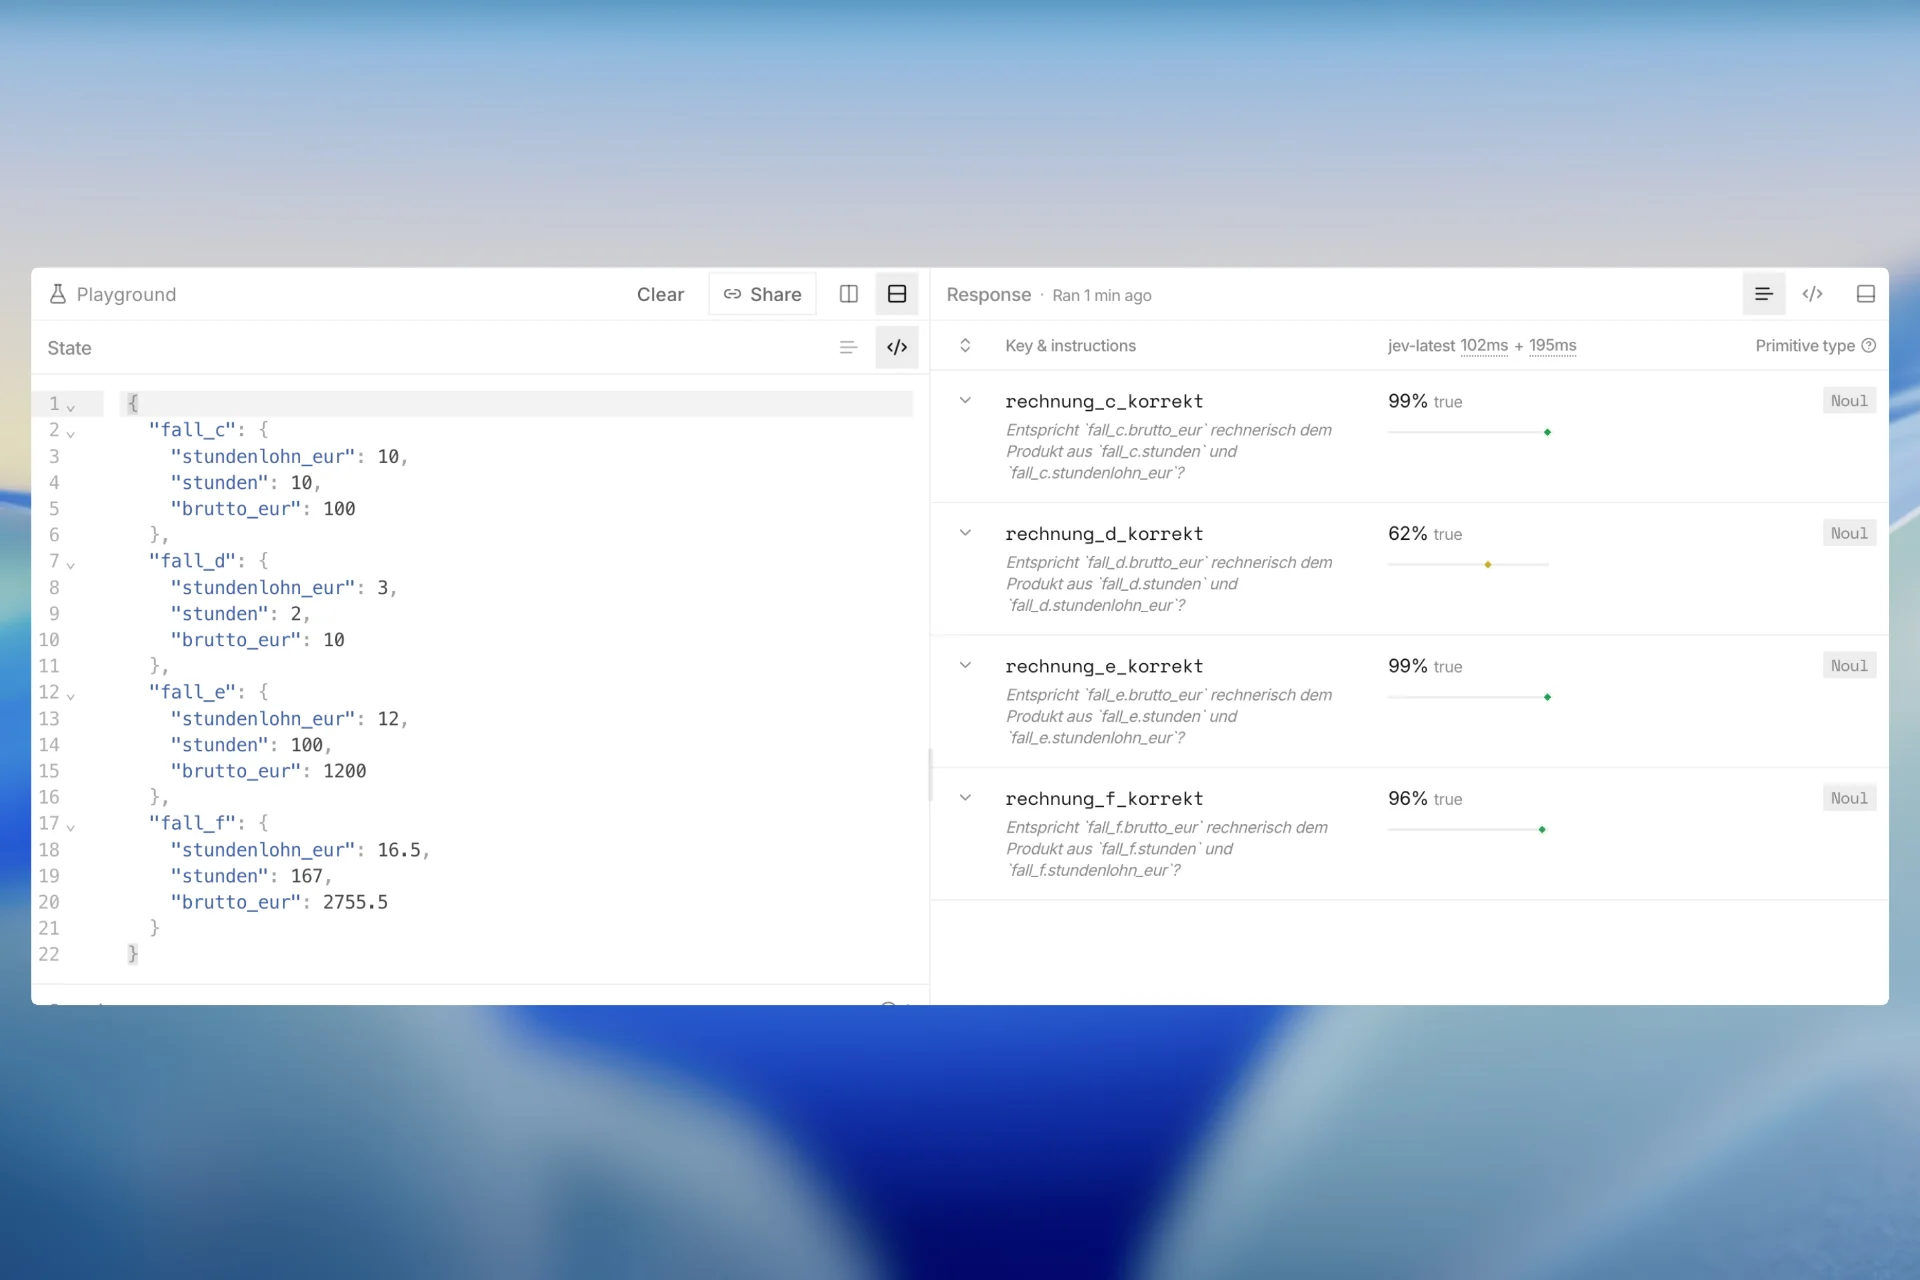
Unsere Rechenprobe bestand aus vier einfachen Abrechnungswerten. Drei Produkte waren korrekt. In einem Fall stand 2 × 3 = 10. Jev sollte jeweils beurteilen, ob das angegebene Brutto rechnerisch dem Produkt aus Stunden und Stundenlohn entspricht.
Die korrekten Rechnungen erhielten 96 bis 99 Prozent. Die falsche Rechnung hielt Jev ebenfalls eher für korrekt. Über vier Läufe mit deutschen und englischen Anweisungen schwankte der Wert zwischen 62 und 95 Prozent. Die falsche Antwort war nur ein Teil des Problems. Die Ausgabe lieferte kein verlässliches Signal dafür, dass die Aufgabe ungeeignet war.
Eine zweite Probe nutzte eine fiktive Betriebsregel: Urlaubsanträge mit mehr als zehn Arbeitstagen benötigen zwei Freigaben. Bis einschließlich zehn Tage genügt die Teamleitung. Jev beurteilte drei Anträge mit fünf, vierzehn und genau zehn Tagen. Die Ergebnisse lagen bei 98, 3 und 97 Prozent und waren in drei Läufen praktisch stabil.
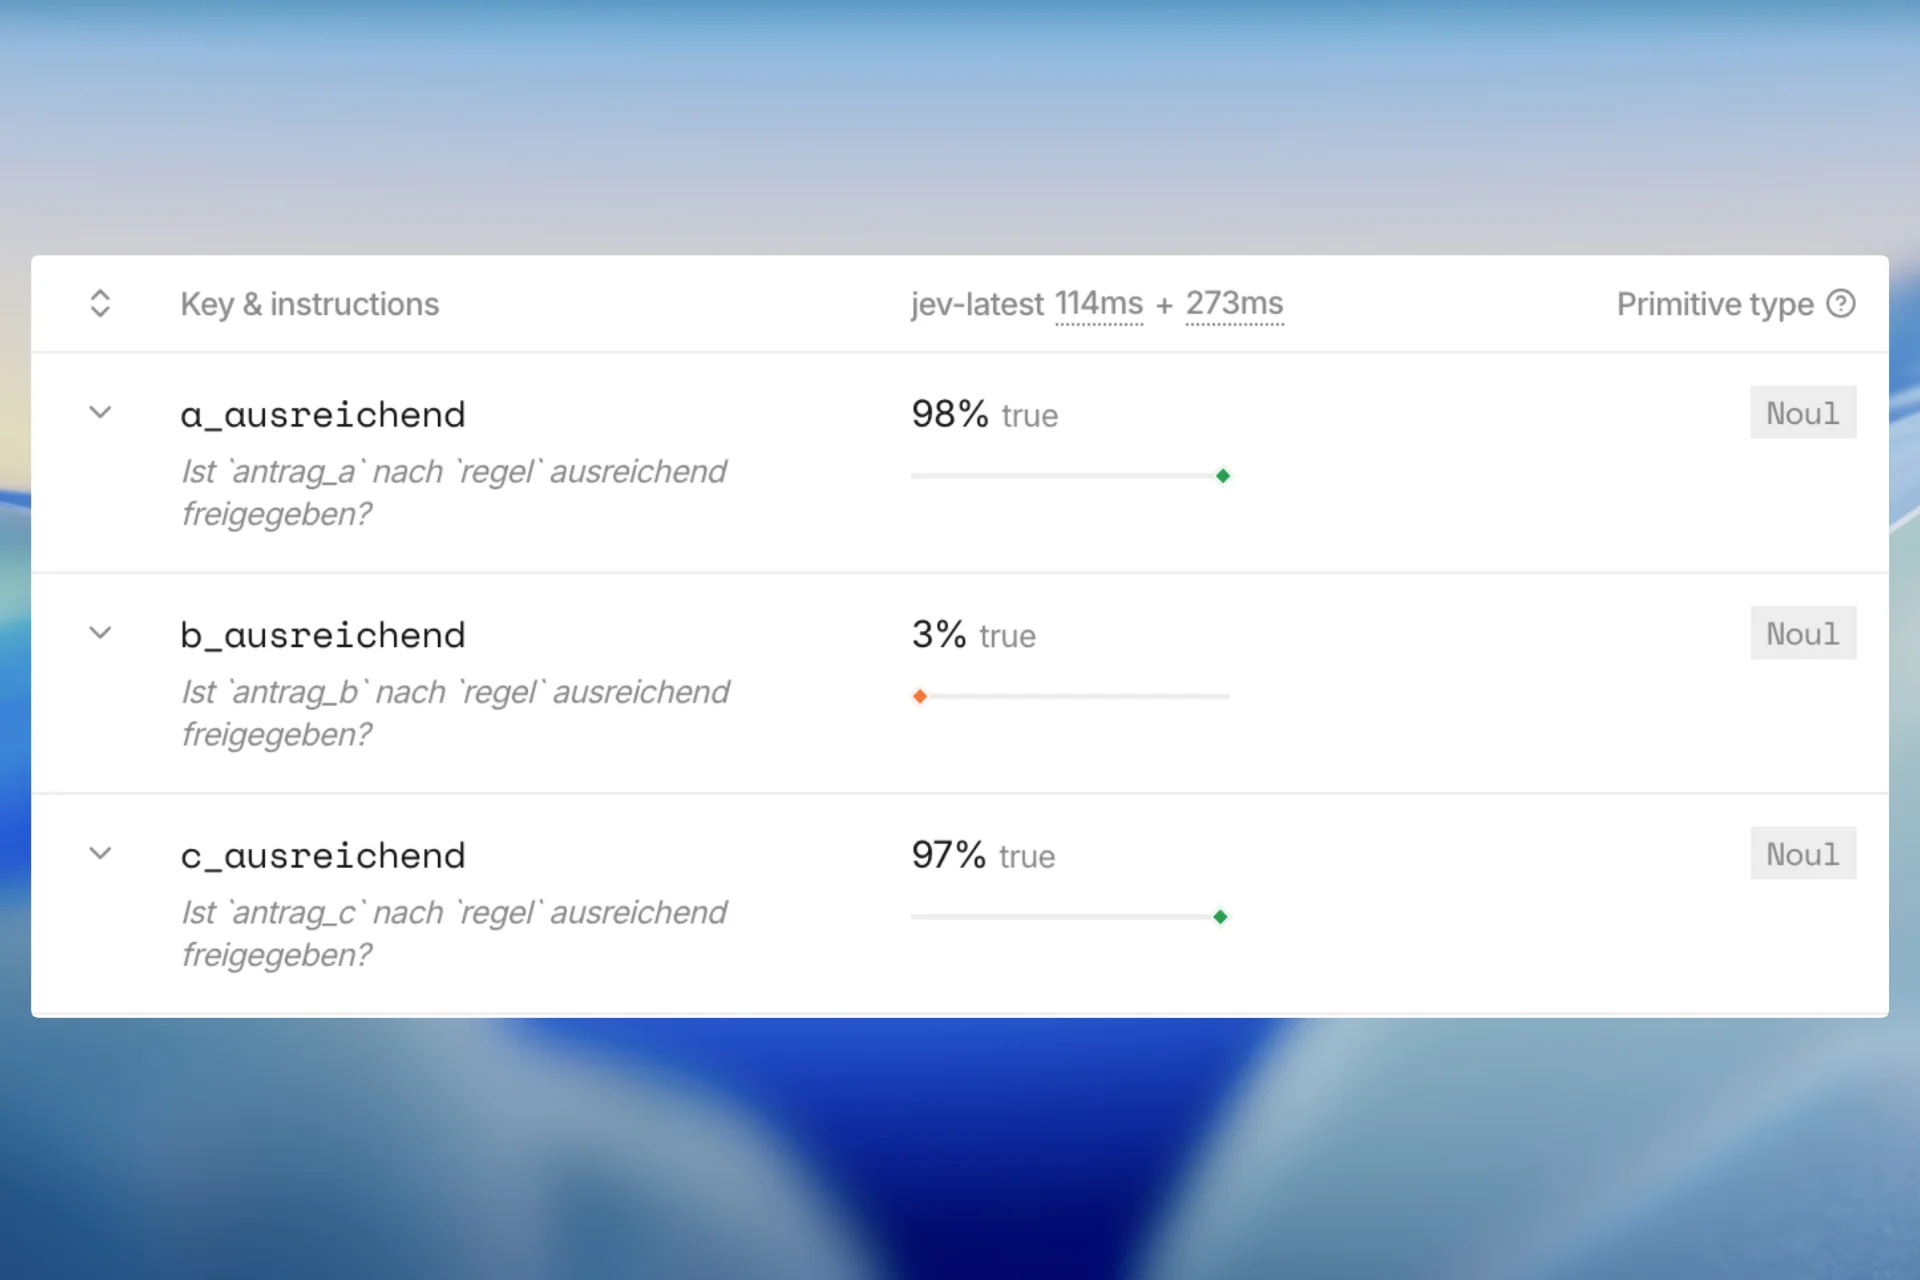
Die beiden Proben bestätigen eine bekannte, aber für den Einsatz entscheidende Arbeitsteilung. Deterministische Berechnungen bleiben im Code. Jev übernimmt sprachliche Urteile über den vorliegenden Fall und die mitgelieferte Regel. Auch dort bestimmt der Code die Folgen, weil er Berechtigungen, Schwellenwerte und zulässige Aktionen verlässlich abbildet.
Code rechnet und steuert. Das Entscheidungsmodell beurteilt Bedeutung. Ein Sprachmodell übernimmt, was Formulierung oder Analyse braucht. Ein Mensch entscheidet bei hohen Folgen und unsicheren Fällen.
Warum ein anschauliches Beispiel schwer zu finden war
Wir haben mehrere aufwendigere Versuchsaufbauten vorbereitet und wieder verworfen. Dazu gehörten eine Angebotsmatrix, ein fachlicher Prüfstand und ein größerer Archivlauf. Für jeden Aufbau legten wir Fragen, Vergleichsbedingungen und erwartete Antworten vor den Läufen fest. Die Ergebnisse waren nachvollziehbar. Um sie korrekt einzuordnen, brauchte es allerdings mehr Erklärung, als ihr Erkenntniswert rechtfertigte.
Der Grund liegt in der Modellklasse. Viele geeignete Jev-Aufgaben sind einfache Klassifizierungen und Bewertungen. Ein Sprachmodell kann sie ebenfalls lösen. Komplexere Aufgaben erzeugen keinen saubereren Vergleich, weil dort Sprache, Fachwissen, Rechnen, Suchschritte und Fragendesign gleichzeitig wirken. Ein einzelner Unterschied lässt sich dann kaum noch Jev, dem Sprachmodell oder dem Versuchsaufbau zurechnen.
Unser größeres Beispiel ist deshalb bewusst schlicht gewählt: 1.000 synthetische Supportanfragen nach Thema, gewünschtem Ergebnis und Ton einordnen. Die Aufgabe ist kein exklusiver Jev-Anwendungsfall. Sie macht Qualität, Zeit, Kosten und Unsicherheit unter denselben Bedingungen vergleichbar.
1.000 Anfragen, zweimal erschlossen
Der Korpus bestand aus englischen Supportanfragen. Englisch ist laut TypeSafe die primäre Trainingssprache von Jev und derzeit die Sprache mit der höchsten Genauigkeit.[4] Für jede Mail legten wir zuerst Thema, gewünschtes Ergebnis und Ton fest. Erst danach wurde der Nachrichtentext erzeugt. Diese drei ursprünglichen Etiketten bildeten später die Referenz. Keine Antwort eines Messmodells wurde zum Maßstab für das andere.
Jev und GPT-5.6 Sol erhielten dieselben drei Fragen und dieselben Kategorien. Beide Seiten arbeiteten mit acht parallelen Aufrufen. Sol lieferte über ein festes JSON-Schema nur die geforderten Werte und lief mit niedriger Reasoning-Einstellung. Diese Konfiguration hielt den Vergleich auf die Klassifizierungsaufgabe begrenzt.
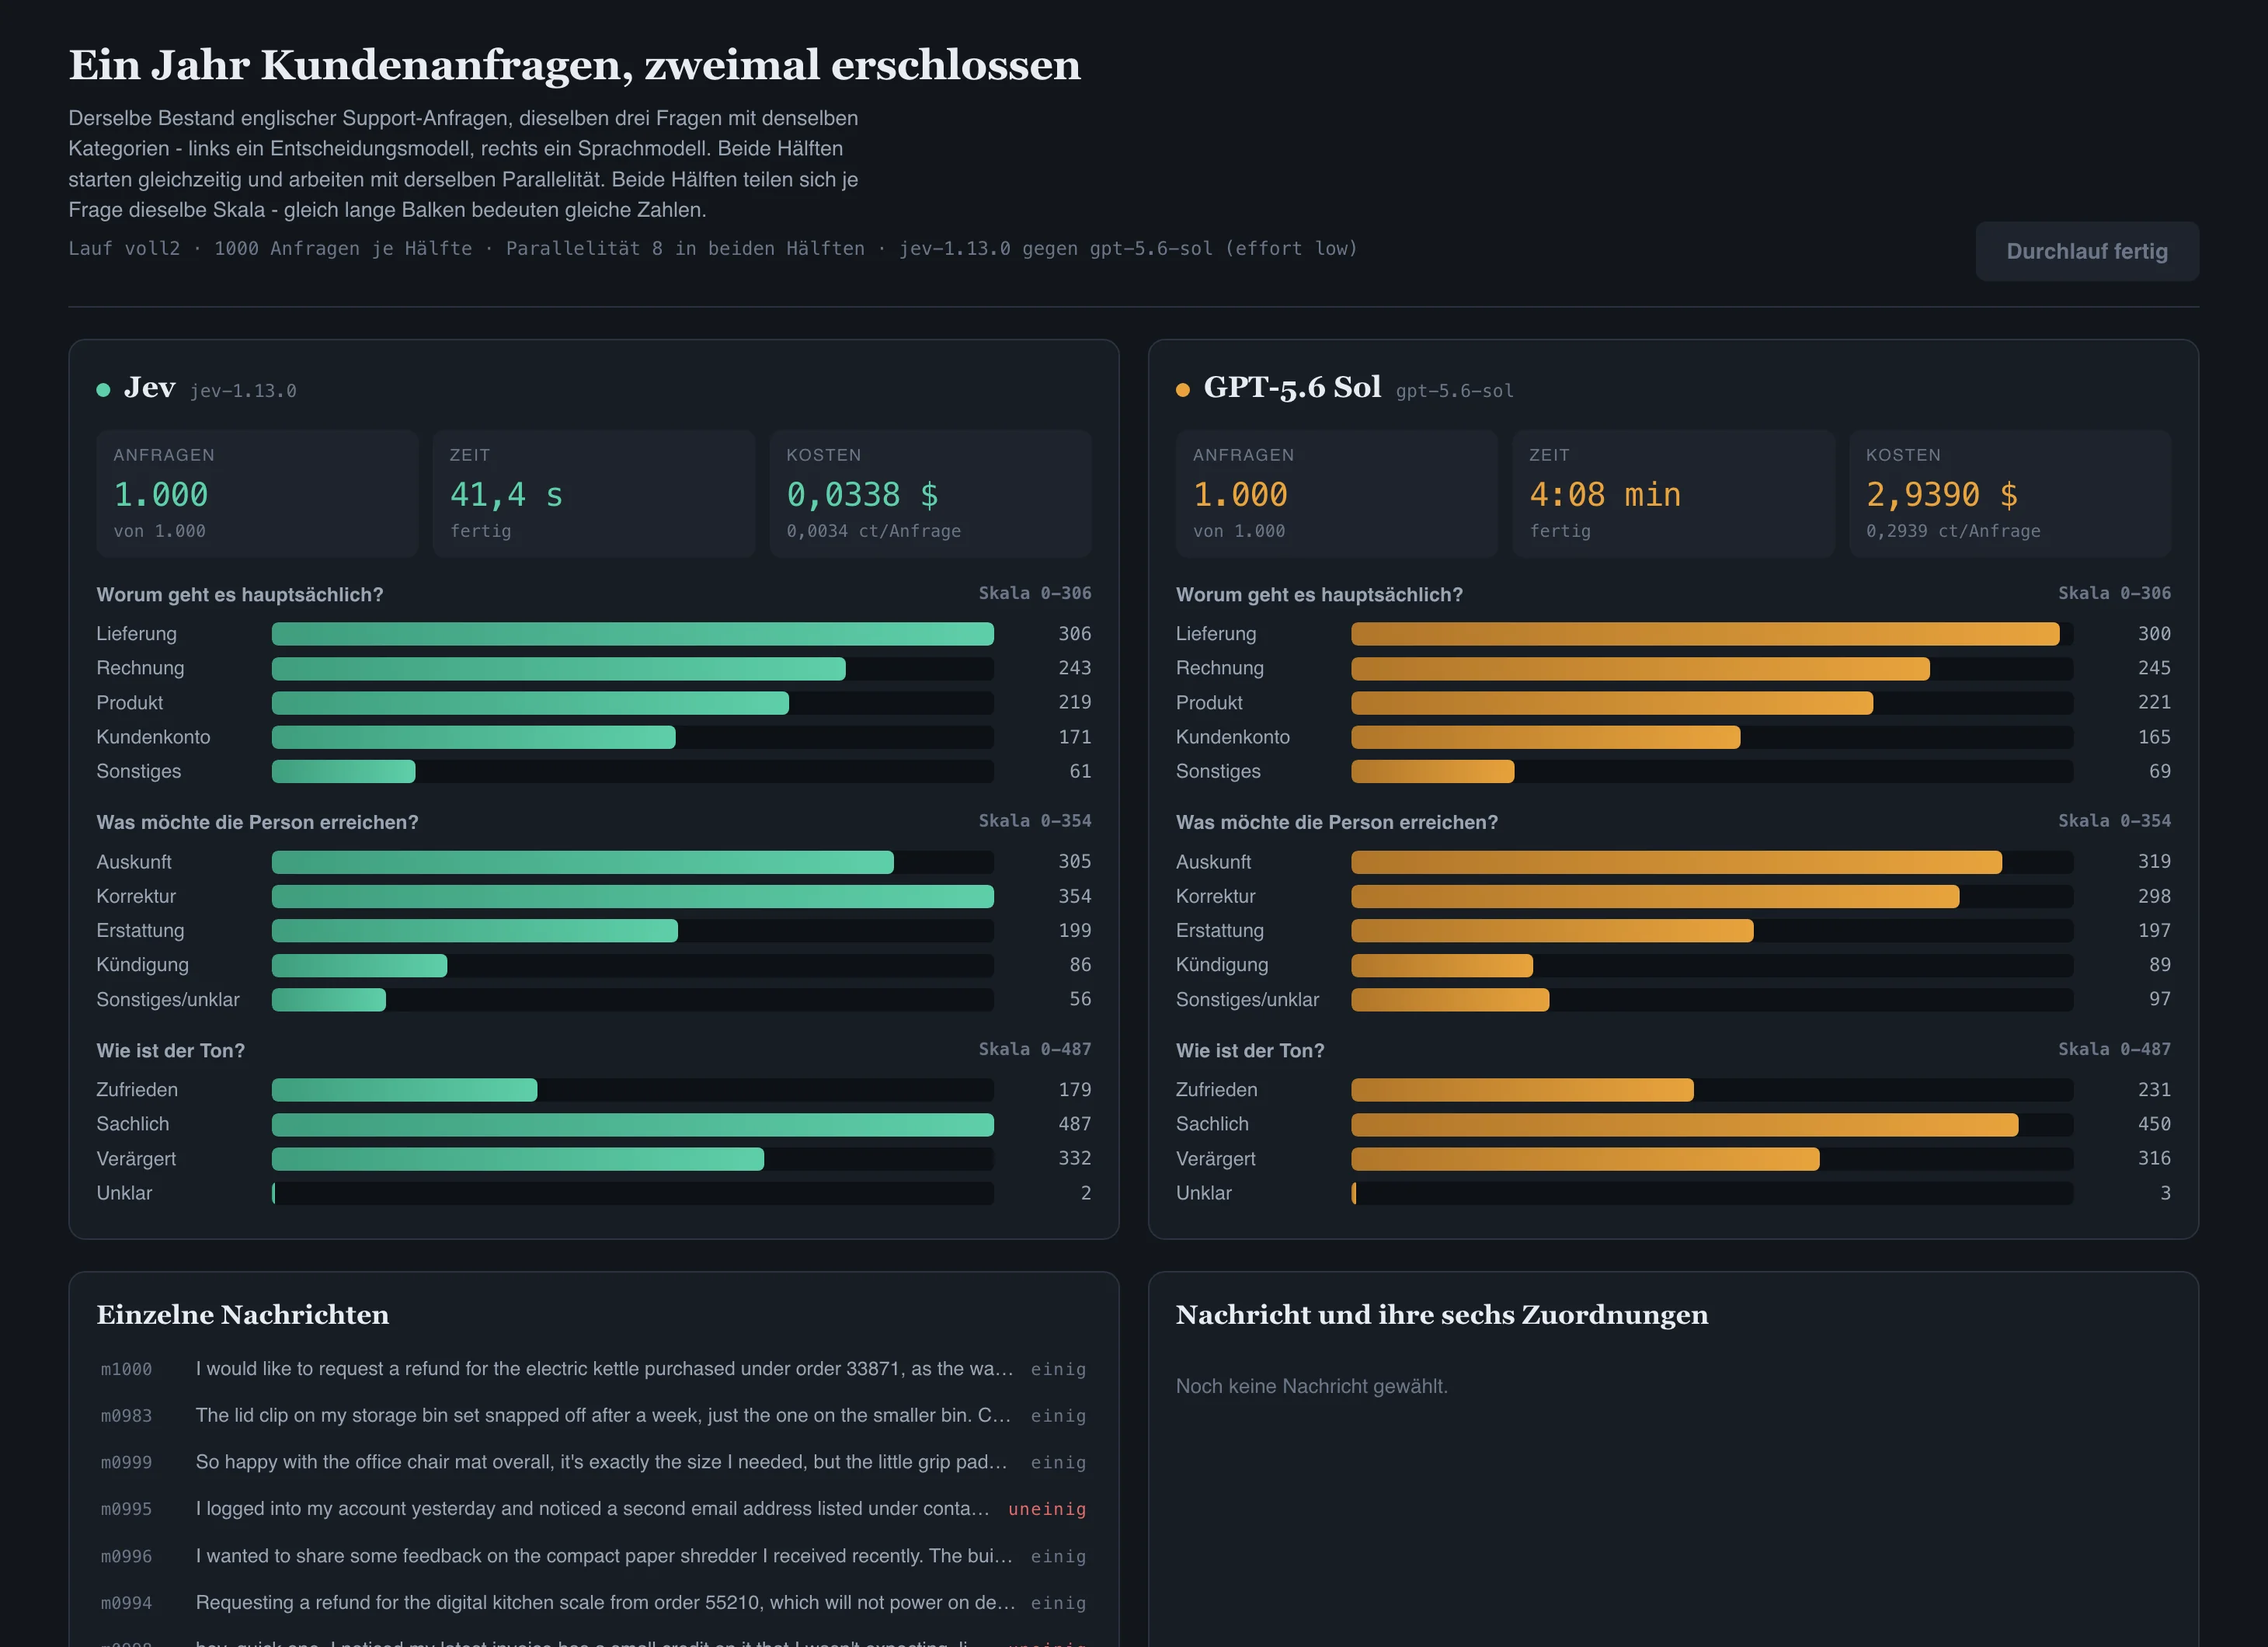
Jev verarbeitete die 1.000 Anfragen in 41,4 Sekunden und kostete 0,0338 Dollar. Sol benötigte 4 Minuten und 8 Sekunden und kostete 2,9390 Dollar. Jev war damit über die gesamte Messung sechsmal schneller und beim Preis um den Faktor 87 günstiger.
Die Qualität ergibt ein anderes Bild. Jev traf 86,8 Prozent der 3.000 Referenzetiketten. Sol erreichte 88,2 Prozent. Der Unterschied lag vor allem bei der Frage, was eine Person mit ihrer Nachricht erreichen wollte. Für diese Aufgabe lieferte das stärkere Sprachmodell etwas häufiger das vorgesehene Etikett.
Der hohe Preisfaktor braucht außerdem einen zweiten Vergleich. GPT-5.6 Sol ist für eine reine Klassifizierung ein sehr großes Modell. GPT-4o mini, ein kleines Sprachmodell von Juli 2024, erreichte im gleichen Lauf 85,4 Prozent und kostete rund 0,10 Dollar.[5] Es lag 1,4 Prozentpunkte hinter Jev und kostete nur etwa das Dreifache. Bei 1.000 Anfragen waren alle drei Varianten absolut billig. Der wirtschaftliche Unterschied wächst, wenn solche Urteile dauerhaft, an vielen Stellen und mit vielen Fragen anfallen.
Für den Sol-Arm galten am Messtag die offiziellen API-Preise von 4 Dollar je Million Eingabetoken und 20 Dollar je Million Ausgabetoken. OpenAI kennzeichnet diese Preise als Aktionspreise, die mindestens bis zum 21. November 2026 gelten.[6] Jevs Preis von 0,042 Dollar je Million Eingabetoken stammt von TypeSafe; Ausgabetoken werden nach der aktuellen Preisliste nicht berechnet.[4]
Konfidenz wird erst mit eigenen Daten nützlich
Jevs interessantester Befund lag in der Beziehung zwischen gemeldeter Sicherheit und Treffern. Bei Ergebnissen ab 0,9 stimmten 94,6 Prozent der Einordnungen mit der Referenz überein. Im Bereich von 0,7 bis 0,9 waren es 68,7 Prozent. Unter 0,7 sank der Wert auf 47,0 Prozent.
Diese Staffelung zeigt, wie ein Prozess mit Unsicherheit arbeiten kann. Hohe Werte können bei einer risikoarmen Aktion automatisch weiterlaufen. Mittlere Werte erhalten eine zusätzliche Prüfung durch ein Sprachmodell. Niedrige Werte gehen an einen Menschen. Die konkreten Schwellen müssen zum eigenen Fall, zu den Folgen einer Fehlentscheidung und zu repräsentativen eigenen Daten passen.
Auch diese Messung hatte eine deutliche Grenze. Für den Ton sah die Referenz 147 Anfragen als „unklar“. Jev wählte diese Kategorie zweimal, Sol dreimal. Beide Modelle entschieden fast immer für eine andere Kategorie. Eine vorgesehene Auffangoption garantiert damit keine angemessene Enthaltung. Fragen, Kategorien und Schwellenwerte müssen anhand der realen Fehlerbilder geprüft werden.
Der Korpus selbst war ebenfalls kein neutraler Goldstandard. Seine Referenzen waren Konstruktionsetiketten. Wir mussten eine erste Fassung verwerfen, weil einzelne erzeugte Texte nicht sauber zu ihren Etiketten passten. In der korrigierten Fassung lag Sol anschließend leicht vor Jev. Das Beispiel zeigt den Aufwand einer belastbaren Bewertung: Ein Modellvergleich prüft immer auch die Qualität der Fragen und der Referenz.
So passt Jev in einen Workflow
Jev passt zu wiederkehrenden Urteilen über Text und strukturierte Zustände. Die möglichen Antworten stehen vorher fest. Viele unabhängige Fragen beziehen sich auf denselben Fall. Der anschließende Workflow kann mit den Ergebnissen, Wahrscheinlichkeiten und Schwellenwerten unmittelbar arbeiten.
Das Muster ist in eigener Software und in einem Automatisierungswerkzeug wie n8n dasselbe. Die ersten Schritte sammeln die benötigten Daten, führen Berechnungen aus und stellen Regeln sowie Berechtigungen bereit. Ein API-Aufruf übergibt diesen State mit den Fragen an Jev. Die folgenden Schritte vergleichen die Antworten mit festgelegten Schwellenwerten und verzweigen den Ablauf. Ein Sprachmodell kommt hinzu, wenn ein Fall eine offene Analyse oder einen formulierten Text benötigt. Menschen prüfen unsichere Fälle und behalten Entscheidungen mit hohen Folgen.
Jev verarbeitet derzeit ausschließlich Text, JSON-Objekte und Textlisten. Bilder, Audio und Video benötigen eine vorgelagerte Umwandlung. TypeSafe gibt an, Kundenanfragen und Antworten nicht zum Training zu verwenden; eine vertraglich zugesicherte Speicherung ohne Datenhaltung wird für Unternehmenskunden beschrieben.[7] Für personenbezogene oder vertrauliche Daten bleibt deshalb vor jedem Einsatz zu klären, welche Daten den Dienst verlassen dürfen und welche Vertragsbedingungen gelten.
Jev nimmt Software keine Entscheidung über Ziele, Risiken und Folgen ab. Es stellt eng gefasste Urteile in einer Form bereit, die Software direkt verwenden kann. Genau darin liegt sein praktischer Wert. Die Qualität des Systems entsteht aus den Fragen, den Daten, den Schwellenwerten und dem Umgang mit den Fällen, in denen das Modell keine belastbare Grundlage liefert.
Für Unternehmen wird Jev dort interessant, wo dieselben kleinen Urteile laufend anfallen und der Preis eines einzelnen Modellaufrufs darüber entscheidet, an wie vielen Stellen intelligente Prüfung wirtschaftlich möglich ist.
Wie ein solcher Ablauf mit Leitplanken und Prüfschritten entsteht, ist der Zuschnitt unseres Automatisierungsprojekts.
Disclaimer: TypeSafes Kundenvertrag schränkt die Veröffentlichung von Benchmarks und Leistungsinformationen ein.[8] Für die Zahlen in diesem Artikel liegt uns eine schriftliche Erlaubnis vor. Herstellerangaben und Ergebnisse unserer eigenen Läufe bleiben im Text klar getrennt.
Quellen
- Daniel Kahneman: „Thinking, Fast and Slow“ (Farrar, Straus and Giroux, 2011)penguinrandomhouse.com ↗↩
- TypeSafe AI: „System One“ (abgerufen am 20. September 2026)docs.typesafe.ai ↗↩
- TypeSafe AI: „How to build with TypeSafe“ (abgerufen am 20. September 2026)docs.typesafe.ai ↗↩
- TypeSafe AI: „Models“ (abgerufen am 20. September 2026)docs.typesafe.ai ↗↩
- OpenAI: „GPT-4o Mini Model“ (abgerufen am 20. September 2026)developers.openai.com ↗↩
- OpenAI: „GPT-5.6 Sol Model“ (abgerufen am 20. September 2026)developers.openai.com ↗↩
- TypeSafe AI: „Legal“ (abgerufen am 20. September 2026)docs.typesafe.ai ↗↩
- TypeSafe AI: „Master Customer Agreement“ (abgerufen am 20. September 2026)typesafe.ai ↗↩